
NVIDIA’nın GeForce RTX 30 ve RTX 40 serisi ekran kartlarında Tensor çekirdeklerine uyguladığı performans sınırlamasını aşan yeni yöntemler geliştirildi. Açık kaynak kodlu GPU Unlock projeleri sayesinde RTX 3090 Ti ve RTX 4090 dahil birçok ekran kartında yapay zekâ hesaplama kapasitesi önemli ölçüde arttı. Yapılan testlerde bazı Tensor işlemleri neredeyse iki kat hızlanırken, değişiklikler ekran kartlarının BIOS yazılımını veya NVIDIA sürücülerini değiştirmeden uygulanabiliyor.
RTX 4090 ve RTX 3090 Ti’ın Tensor Performansı İki Katına Yaklaştı
NVIDIA’nın Ampere ve Ada Lovelace mimarilerini kullanan ekran kartları, belirli Tensor işlemlerinde donanımın ulaşabildiği en yüksek hesaplama hızının altında çalışıyordu. GPU Unlock ve GPU Unlock Ada isimli açık kaynak projeleri, grafik işlemcilerinin açılış sırasında kullandığı hız yapılandırmasını değiştirerek bu sınırlamayı aşmayı başardı. Böylece özellikle FP16, BF16 ve TF32 formatlarında gerçekleştirilen matris hesaplamalarında ciddi performans kazanımları elde edildi.
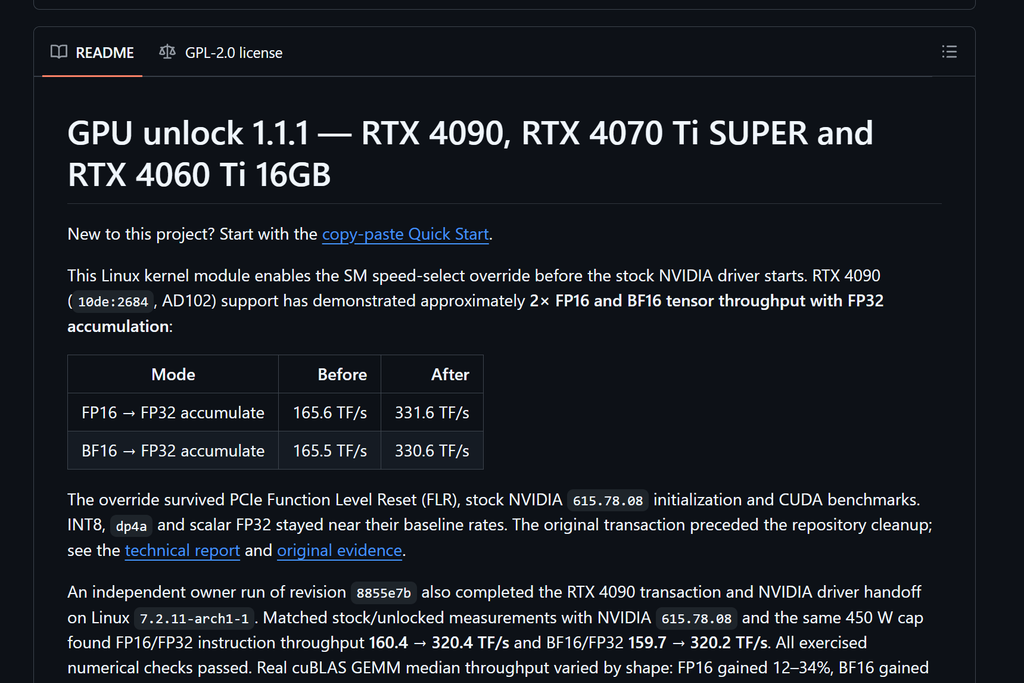
En yüksek işlem kapasitesine sahip GeForce RTX 40 serisi modeli olan RTX 4090, gerçekleştirilen testlerde dikkat çekici sonuçlar verdi. FP16 hesaplama performansı 165,6 TFLOPS’tan 331,6 TFLOPS’a çıkarken BF16 işlemlerinde 165,5 TFLOPS olan değer 330,6 TFLOPS’a ulaştı. Her iki sonuç da belirli Tensor hesaplamalarında yaklaşık yüzde 100 performans artışına karşılık geliyor.
RTX 4090 üzerinde 24 Ekim 2026 tarihinde gerçekleştirilen başka bir testte NVIDIA 615.78.08 sürücüsü ve 450W güç sınırı kullanıldı. FP16 işlem kapasitesi 160,4 TFLOPS’tan 320,4 TFLOPS’a, BF16 kapasitesi ise 159,7 TFLOPS’tan 320,2 TFLOPS’a yükseldi. Test sonuçları karşılaştırılırken hesaplamaların doğruluğu da kontrol edildi.
Bununla birlikte teorik Tensor işlem kapasitesindeki artış ile gerçek yapay zekâ uygulamalarında elde edilen hızlanma birbirinden farklı. RTX 4090 üzerinde cuBLAS aracılığıyla yapılan FP16 matris çarpımı testlerinde yüzde 12 ile yüzde 34 arasında performans kazanımı kaydedildi. BF16 testlerinin bir bölümünde yüzde 16 ile yüzde 20 arasında artış görülürken, bazı matris boyutlarında performans neredeyse değişmedi.
RTX 40 serisinin diğer modelleri üzerinde de çalışmalar gerçekleştirildi. RTX 4070 Ti SUPER, 240W güç sınırında yapılan testlerde FP16 hesaplama kapasitesini 95 TFLOPS’tan 189,9 TFLOPS’a yükseltti. BF16 tarafında 189,7 TFLOPS ölçülürken TF32 performansı 47,49 TFLOPS’tan 94,51 TFLOPS’a çıktı.
Aynı ekran kartının FP8 sonuçlarında kullanılan yazılımın ve hesaplama yönteminin etkisi görüldü. Standart CUTLASS testinde 59,326 TFLOPS’tan 59,495 TFLOPS’a yükselen performans, CUTLASS 4.8.1’in hızlı biriktirme yöntemiyle yapılan başka bir testte 158,54 TFLOPS’tan 309,08 TFLOPS’a ulaştı. İkinci ölçümde yüzde 95’e yakın hızlanma kaydedilirken, ilk testteki artış yüzde 1’in altında kaldı.
RTX 4080 SUPER için paylaşılan ölçümlerde de FP16 performansının 110,6 TFLOPS’tan 202,7 TFLOPS’a yükseldiği belirtildi. Bu sonuç yaklaşık yüzde 83’lük bir artışa karşılık geliyor. Ancak modelin farklı sistemlerde aynı kazanımı sağladığını gösteren kapsamlı doğrulama testleri henüz bulunmuyor.
RTX 4060 Ti 16 GB modeli de GPU Unlock Ada çalışmalarına dahil edildi. AD106 grafik işlemcisini kullanan kartta gerçekleştirilen ilk denemelerde NVIDIA sürücüsü başarıyla başlatıldı ve değiştirilen Tensor hız ayarlarının çalıştığı doğrulandı. 165W güç sınırıyla yapılan ölçümlerde FP16 için 91 TFLOPS, TF32 için 46,9 TFLOPS ve INT4 için 374,9 TOPS değerleri kaydedildi. Bununla birlikte aynı koşullarda oluşturulmuş kilit öncesi karşılaştırma sonuçları bulunmadığından kesin performans artışı oranı belirlenemedi.
Gelişmeler yalnızca RTX 40 serisiyle sınırlı kalmadı. Ampere mimarili RTX 30 serisi için hazırlanan orijinal GPU Unlock yazılımı, GA102, GA103, GA104 ve GA106 grafik işlemcilerindeki FP16 ve BF16 Tensor komutlarının çalışma hızını artırabiliyor. RTX 3090 Ti üzerinde gerçekleştirilen karşılaştırmalı testler, sınırlamanın kaldırılmasıyla işlem kapasitesinde önemli değişiklikler olduğunu ortaya koydu.
RTX 3090 Ti’ın FP16 performansı 87,46 TFLOPS’tan 118,39 TFLOPS’a yükseldi. BF16 hesaplamalarında 87,50 TFLOPS olan değer 157,41 TFLOPS’a ulaşırken, TF32 performansı 42,58 TFLOPS’tan 82,61 TFLOPS’a çıktı. BF16 işlemlerindeki artış yaklaşık yüzde 80, TF32 tarafındaki artış ise yüzde 94 seviyesinde gerçekleşti.
RTX 3090, RTX 3080, RTX 3070 ve RTX 3060 ekran kartlarında da benzer testler yapıldı. BF16 matris çarpımı işlemlerinde RTX 3090 için yüzde 25 ile yüzde 67, RTX 3080 10 GB için yüzde 70 ile yüzde 73 ve RTX 3070 için yüzde 73 ile yüzde 81 arasında değişen hızlanmalar ölçüldü. Elde edilen sonuçlar ekran kartının güç tüketimi sınırına, kullanılan matematiksel işlemlere ve test ortamına bağlı olarak farklılık gösterdi.
Yapay zekâ modellerinin gerçek çalışma koşullarında gerçekleştirilen ölçümlerde ise daha sınırlı ancak dikkat çekici performans kazanımları kaydedildi. Büyük dil modellerinin giriş verilerini işlediği prefill aşamasında yüzde 14 ile yüzde 36 arasında hızlanma görüldü. Bellek bant genişliğinin belirleyici olduğu token üretimi aşamasında ise aynı seviyede kazanım sağlanamadı. INT8 hesaplamalarında da kayda değer bir değişiklik oluşmadı.
Performans sınırlamasını kaldırmak için kullanılan yöntem, grafik işlemcisinin açılış aşamasındaki donanım yapılandırmasına müdahale ediyor. Linux üzerinde çalışan özel çekirdek modülü, NVIDIA sürücüsü yüklenmeden önce GPU’nun ilgili hız seçimi ayarlarını değiştiriyor. Ardından PCIe Function Level Reset işlemi uygulanıyor ve ekran kartı standart NVIDIA sürücüsüyle çalışmaya devam ediyor.
RTX 40 serisinde kullanılan GPU Unlock Ada, TOTORONG tarafından geliştirilen AD102 firmware çalışmasını temel alan bir uygulama içeriyor. Firmware bileşenleri kullanıcının bilgisayarında hazırlanırken, Linux tarafında ekran kartının vBIOS yazılımını yeniden programlamak gerekmiyor. NVIDIA sürücüsünün değiştirilmesine de ihtiyaç duyulmuyor.
Ancak uygulamanın kurulumu için Linux çekirdek modülünün hazırlanması, başlangıç yapılandırmasının değiştirilmesi ve gerekli açılış parametrelerinin ayarlanması gerekiyor. Bazı sistemlerde Secure Boot nedeniyle ek yapılandırma veya modül imzalama işlemleri gerekebiliyor. Ayrıca donanım ayarlarının etkinleşmesi için bilgisayarın tamamen kapatılarak yeniden açılması gerekebiliyor.
Windows sistemlerinde ise farklı bir uygulama üzerinde çalışmalar sürüyor. UEFI tabanlı yöntemle MSI RTX 4070 Ti ekran kartı ve Z490 anakart kullanılan bir sistemde başarılı sonuçlar elde edildi. FP16 performansı 84,08 TFLOPS’tan 151,43 TFLOPS’a yükselirken BF16 işlemlerinde 84,03 TFLOPS’tan 148,25 TFLOPS’a ulaşıldı. Bu ölçümler sırasıyla yüzde 80,1 ve yüzde 76,4 performans artışına karşılık geliyor.
Bununla birlikte Windows için geliştirilen UEFI uygulaması henüz bütün sistemlerle uyumlu genel kullanıma açık bir çözüm değil. Linux sürümünün de farklı ekran kartı, anakart ve sürücü kombinasyonlarında sorunsuz çalışacağı garanti edilmiyor. GPU’nun açılış yapılandırmasına müdahale eden yöntemlerin kararlılık üzerindeki uzun vadeli etkileri de kapsamlı biçimde doğrulanmış değil.
Tensor işlemlerinde elde edilen yüksek performans artışı, oyunların veya ekran kartındaki bütün hesaplama birimlerinin aynı oranda hızlanacağı anlamına gelmiyor. Ölçülen kazanımlar özellikle FP16, BF16 ve TF32 gibi veri biçimleriyle çalışan belirli yapay zekâ ve matris hesaplamalarında ortaya çıkıyor. Standart FP32 hesaplamaları ve INT8 işlemleri ise bu değişikliklerden aynı ölçüde etkilenmiyor.
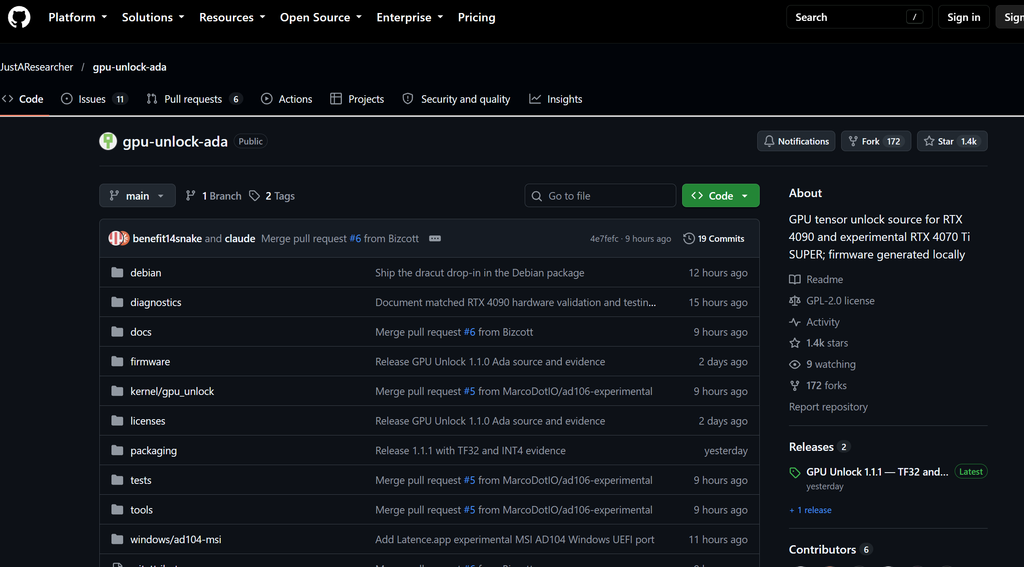
GPU Unlock Ada projesinin 1.1.1 sürümünde RTX 4090 desteğinin yanında RTX 4070 Ti SUPER ve RTX 4060 Ti 16 GB için deneysel çalışmalar da yer alıyor. RTX 4090 D modeli için de deneysel destek bulunurken, RTX 30 serisine yönelik GPU Unlock projesinde yeni ekran kartı ve uygulama testleri devam ediyor. Her iki projenin kaynak kodları GitHub üzerinden erişime açık durumda.
