
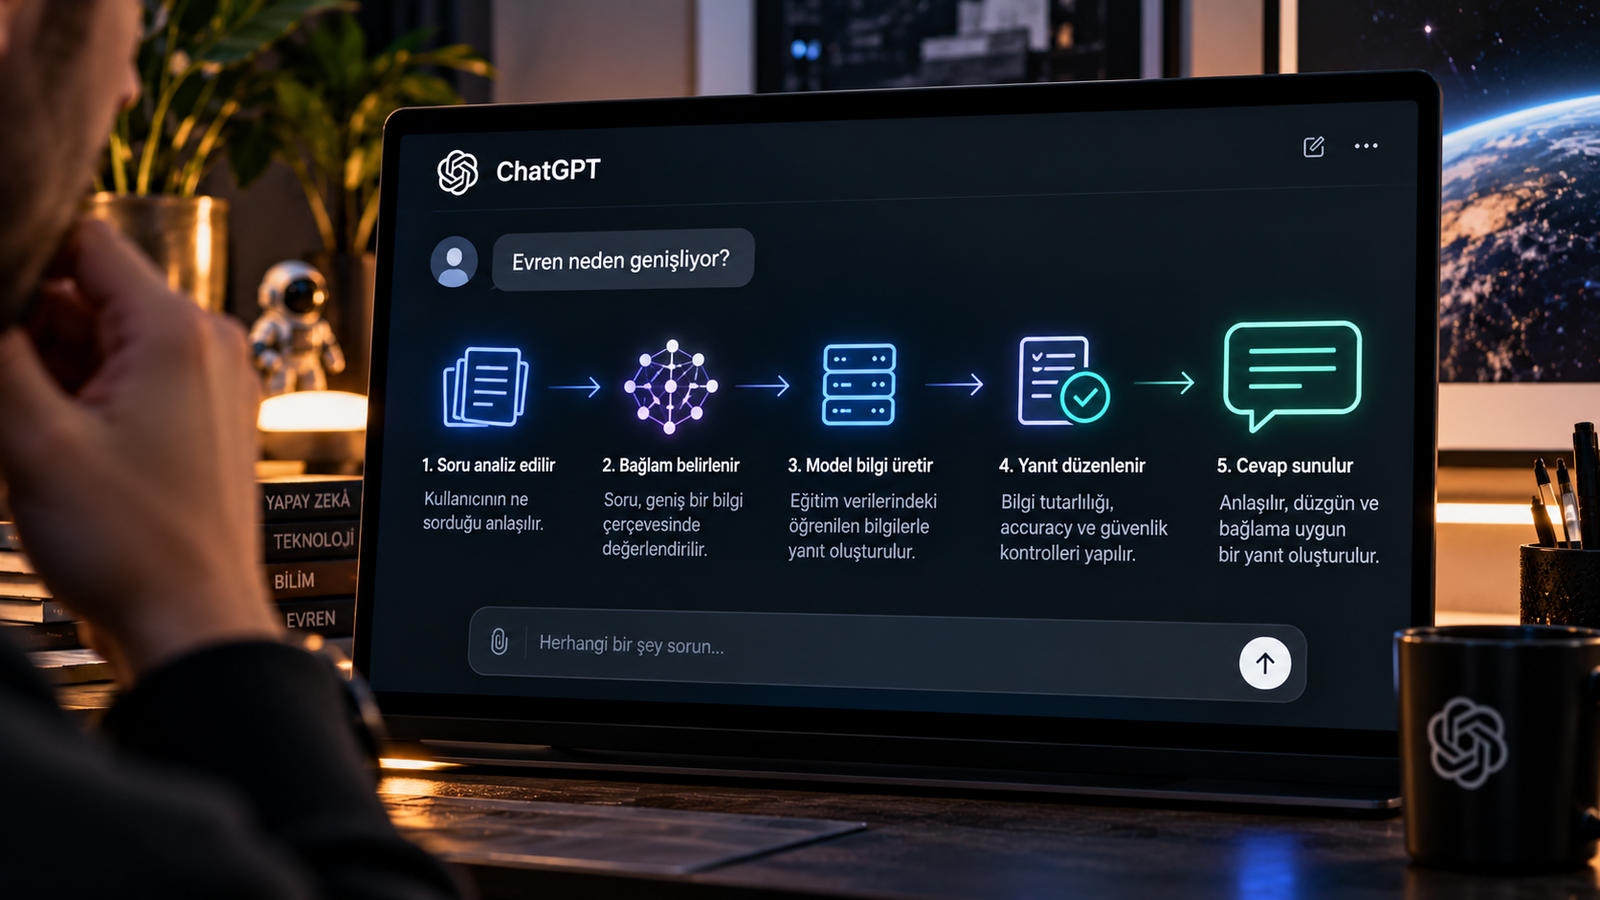
ChatGPT’ye bir soru yazdığınızda arka planda yalnızca internette uygun cevabın aranıp ekrana getirilmesi gibi basit bir işlem gerçekleşmiyor. Yazdığınız metin önce modelin işleyebileceği daha küçük parçalara ayrılıyor, konuşmanın bağlamıyla birlikte değerlendiriliyor ve yapay sinir ağı olası cevapları token token oluşturmaya başlıyor.
Bu süreç bazı sorularda yalnızca modelin eğitim sırasında öğrendiği örüntülere dayanırken güncel bilgi gerektiğinde web araması, dosya okuma, hesaplama veya farklı araçların kullanılması da devreye girebiliyor. ChatGPT’nin cevabı bu nedenle hazır bir veri tabanından çekilen sabit metin değil; o anda verilen soru, konuşmanın bağlamı, kullanılabilen araçlar ve modeli oluşturan milyarlarca matematiksel ilişkinin birlikte çalışmasıyla üretiliyor.
İlk olarak yazdığınız soru parçalara ayrılıyor
ChatGPT yazdığınız cümleyi bilgisayarın doğrudan anlayabileceği bir “anlam” olarak almıyor. Metin önce token adı verilen küçük birimlere ayrılıyor. Bir token bazen bütün bir kelimeyi, bazen kelimenin bir bölümünü, bazen noktalama işaretini veya birkaç karakterlik bir parçayı temsil edebiliyor.
Örneğin “Elektrikli otomobiller nasıl çalışıyor?” şeklindeki bir soru model içerisinde tam olarak beş veya altı kelimeden oluşan bir yapı olarak işlenmek zorunda değil. Kullanılan tokenizer’a ve dile göre kelimeler daha küçük parçalara ayrılabiliyor. Türkçedeki eklemeli yapı nedeniyle tek bir uzun kelime birden fazla token haline gelebiliyor.
Modelin gördüğü şey sonuçta kelimelerin kendisinden ziyade bu tokenların sayısal karşılıkları. Her token belirli bir kimliğe dönüştürülüyor ve yapay sinir ağının işleyebileceği matematiksel temsiller oluşturuluyor.
Bu işlem yalnızca kullanıcı mesajına uygulanmıyor. Konuşmada kullanılan önceki mesajlar, sistemin gerekli talimatları, varsa dosyalardan alınan bilgiler ve araçlardan dönen sonuçlar da modelin işleyebileceği biçime dönüştürülüyor.
ChatGPT sorunun yalnızca son cümlesine bakmıyor
Bir sohbet sırasında “Peki bunun dezavantajı ne?” yazdığınızda ChatGPT’nin “bunun” kelimesinin neyi ifade ettiğini anlaması için önceki mesajlara ihtiyacı bulunuyor. Bu nedenle model belirli bir bağlam penceresi içerisinde konuşmanın ilgili bölümlerini birlikte değerlendiriyor.
Bağlam yalnızca kullanıcı tarafından yazılan son mesajdan oluşmayabiliyor. Sohbet geçmişindeki ilgili bilgiler, yüklenen dosyalar, görseller ve kullanılabilen kişisel bağlam özellikleri de ürünün yapılandırmasına bağlı olarak cevabın oluşturulmasına katkıda bulunabiliyor.
Ancak modelin bütün geçmişinizi sınırsız biçimde aynı anda önünde tuttuğunu düşünmek doğru değil. Modeller belirli miktarda tokenı aynı bağlam içerisinde işleyebiliyor ve ürün tarafında hangi bilgilerin ilgili olduğuna göre farklı içerikler modele sunulabiliyor.
Bu nedenle aynı cümle farklı konuşmalarda farklı cevaplar üretebilir. “Hangisi daha iyi?” sorusu tek başına çok az bilgi taşırken öncesinde iki ekran kartı konuşuluyorsa anlamı tamamen değişiyor.
Kelimeler nasıl sayılara dönüşüyor?
Tokenlar model içerisinde yalnızca sıra numaraları olarak kullanılmıyor. Her token, çok boyutlu bir matematiksel temsil olan vektörlere dönüştürülüyor. Bu işlemin temelinde embedding adı verilen temsil yöntemi bulunuyor.
Bu sayısal uzayda kelimeler veya kavramlar arasındaki ilişkiler doğrudan sözlük anlamı biçiminde saklanmıyor. Eğitim sırasında oluşan matematiksel yapı sayesinde benzer bağlamlarda kullanılan ifadelerin temsilleri arasında ilişkiler ortaya çıkıyor.
Örneğin “otomobil”, “motor”, “tekerlek” ve “sürüş” kelimeleri birçok metinde belirli bağlamlarda birlikte görüldüğü için model bunların ilişkili kavramlar olduğunu öğrenebiliyor. Aynı şekilde bir programlama dilindeki sözdizimi, tarihsel olaylar arasındaki bağlantılar veya bir cümlenin dilbilgisel yapısı da eğitim sırasında oluşan parametrelere yansıyor.
Burada modelin insan beynindeki gibi bir sözlük açıp “otomobil” kelimesinin tanımını okuduğunu düşünmemek gerekiyor. Anlam, çok büyük sayıdaki matematiksel ilişkinin birlikte oluşturduğu dağıtılmış temsiller üzerinden ortaya çıkıyor.
Attention mekanizması ne işe yarıyor?
Modern büyük dil modellerinin temel tekniklerinden biri attention, yani dikkat mekanizması. Bu yapı modelin bir tokenı işlerken bağlam içerisindeki diğer tokenların hangilerinin daha önemli olduğunu matematiksel olarak değerlendirmesini sağlıyor.
Örneğin “Ali kitabı Mehmet’e verdi çünkü o istemişti” gibi bir cümlede “o” zamirinin kimi ifade ettiğini anlamak için cümlenin diğer bölümleriyle ilişki kurulması gerekiyor. Model, bağlam içerisindeki tokenlar arasındaki ilişkileri değerlendirerek bu tür bağlantıları oluşturabiliyor.
Daha uzun metinlerde attention çok daha önemli hale geliyor. Bir kullanıcının birkaç paragraf önce belirttiği bir koşul, cevabın daha sonraki bölümünü değiştirebilir ve model ilgili bilgiyle mevcut token arasında bağlantı kurmaya çalışır.
Bu mekanizma basit bir anahtar kelime eşleştirmesinden çok daha karmaşık. Her katmanda farklı matematiksel dönüşümler uygulanıyor ve model bağlamı giderek daha zengin temsil biçimlerine dönüştürüyor.
ChatGPT cevabı bir yerden kopyalıyor mu?
Normal bir soruda ChatGPT’nin yaptığı işlem, eğitim verilerinde birebir aynı soruyu bulup karşısındaki cevabı ekrana taşımak değil. Model eğitim sırasında gördüğü verilerdeki dil, bilgi ve ilişki örüntülerini parametrelerine yansıtıyor ve cevap üretirken bu parametreleri kullanıyor.
Modelin parametreleri çok büyük miktarda sayısal değerden oluşuyor. Eğitim sırasında bu değerler sürekli değiştirilerek modelin sonraki tokenı daha doğru tahmin etmesi sağlanıyor.
Bu nedenle modelin içerisinde klasik anlamda “Fransa’nın başkenti = Paris” şeklinde satırlardan oluşan bir veritabanı bulunmuyor. Bunun yerine bu bilgi ve benzeri milyonlarca ilişki, modelin parametreleri içerisine dağıtılmış matematiksel örüntüler halinde yansıyor.
Büyük dil modellerinin zaman zaman eğitim verilerindeki belirli ifadeleri hatırlayabilmesi veya benzer biçimde üretebilmesi mümkün olsa da çalışma prensibi genel olarak belgeleri depolayıp gerektiğinde kopyalamaya dayanmıyor.
Eğitim sırasında model ne öğreniyor?
Temel eğitim aşamasında model çok büyük miktarda içerik üzerinde sonraki tokenı tahmin etmeyi öğreniyor. OpenAI, temel modellerini geliştirirken herkese açık internet içeriği, üçüncü taraflarla yapılan anlaşmalarla erişilen bilgiler ve kullanıcılar, insan eğitmenler ile araştırmacılar tarafından sağlanan veya oluşturulan içerikler gibi farklı kaynaklardan yararlanıldığını açıklıyor.
Eğitimin basitleştirilmiş haliyle modelin karşısına “Dün gece çok yağmur yağdığı için yollar…” şeklinde bir metin geldiğini düşünelim. Model bir sonraki token için farklı olasılıklar üretir ve gerçek eğitim örneğiyle arasındaki hata hesaplanır.
Bu hata daha sonra sinir ağındaki parametrelerin çok küçük miktarlarda değiştirilmesinde kullanılıyor. Milyarlarca örnek boyunca tekrarlanan bu işlem sonunda model dilbilgisi, yazım, kavram ilişkileri, bilgi örüntüleri ve çok daha karmaşık yapılar konusunda güçlü tahmin yeteneği kazanıyor.
Eğitim yalnızca kelimelerin yan yana gelme sıklığını ezberlemekten ibaret kalmıyor. Model ölçeği büyüdükçe uzun bağlamları takip etme, örneklerden genelleme yapma, kod yazma, matematiksel ilişkiler kurma ve farklı problemleri çözme gibi daha karmaşık yetenekler ortaya çıkabiliyor.
“Sonraki kelimeyi tahmin ediyor” demek neden eksik kalıyor?
ChatGPT için sık kullanılan açıklamalardan biri “yalnızca sonraki kelimeyi tahmin ediyor” ifadesi. Teknik temel açısından model gerçekten sıradaki token için olasılıklar hesaplıyor ancak bu açıklama tek başına sistemin yaptığı işlemi yeterince tarif etmiyor.
Bir sonraki tokenın doğru seçilebilmesi için modelin kimi zaman bütün paragrafın anlamını, sorudaki koşulları, matematik probleminin ara adımlarını veya yazılan kodun yapısını takip etmesi gerekiyor. Basit bir sonraki kelime görevi, yeterince büyük model ve veri ölçeğinde çok karmaşık ilişkilerin öğrenilmesini gerektiriyor.
Örneğin kullanıcıdan 1.000 kelimelik bir metni özetlemesi istendiğinde model yalnızca son birkaç kelimeye bakarak başarılı bir özet oluşturamaz. Metindeki ana fikirleri, tekrarları ve ilişkileri bağlam içerisinde işlemesi gerekiyor.
Bu yüzden “gelişmiş otomatik tamamlama” benzetmesi mekanizmanın bir yönünü anlatıyor ancak modern büyük dil modellerinin ortaya çıkardığı davranışların tamamını açıklamıyor.
ChatGPT cevabın ilk kelimesini nasıl seçiyor?
Model soruyu işledikten sonra olası bir sonraki tokenlar için skorlar oluşturuyor. Bu skorlar daha sonra olasılık dağılımına dönüştürülüyor ve sistem hangi tokenın üretileceğine karar veriyor.
Örneğin “Türkiye’nin başkenti…” ifadesinin ardından “Ankara” tokenının olasılığı çok yüksek olabilir. Daha yaratıcı bir yazı isteğinde ise aynı noktada mantıklı olabilecek çok sayıda farklı token birbirine daha yakın olasılıklara sahip olabilir.
Seçilen token bağlama ekleniyor ve model aynı işlemi yeniden yapıyor. İkinci token, ilk üretilen token da hesaba katılarak oluşturuluyor; ardından üçüncü, dördüncü ve sonraki tokenlar geliyor.
Ekranda bir cümleyi akıcı şekilde görsek de arka planda cevap parça parça oluşturuluyor. Bu işlem saniyede çok sayıda token üretilebildiği için kullanıcı açısından kesintisiz yazı yazılıyormuş gibi görünüyor.
Cevabın tamamı önceden hazırlanıyor mu?
Klasik dil modeli üretiminde görünür cevabın tamamı ilk kelime yazılmadan önce hazır halde beklemiyor. Model tokenları ardışık biçimde oluşturuyor ve daha önce oluşturduğu çıktıyı da sonraki tokenların bağlamına dahil ediyor.
Bu durum cevabın ortasında yapılan bir tercihin sonraki paragrafları da etkilemesine neden olabiliyor. Model bir açıklamayı belirli bir yönde kurduğunda daha sonraki cümleler de o bağlama uygun şekilde devam ediyor.
Reasoning, yani akıl yürütme için optimize edilmiş modellerde görünür cevaptan önce veya cevap üretimi sırasında ek hesaplama yapılabiliyor. Bu modeller kullanıcıya gösterilmeyen iç reasoning tokenları kullanarak problemi parçalara ayırabilir, farklı yaklaşımları değerlendirebilir ve daha sonra görünür yanıtı oluşturabilir.
Bu iç işlemlerin tamamı kullanıcıya ham biçimde gösterilmiyor. Kullanıcı sonuçta modelin hazırladığı nihai yanıtı görüyor.
Aynı soruya neden her seferinde aynı cevap gelmiyor?
Bir sorunun devamında çoğu zaman birden fazla makul token bulunuyor. Model yalnızca matematiksel olarak en yüksek olasılığa sahip tokenı her aşamada zorunlu olarak seçmek yerine üretim ayarlarına bağlı olarak olasılık dağılımından farklı seçimler yapabiliyor.
Bu nedenle aynı soru iki kez sorulduğunda ana bilgi aynı kalmasına rağmen cümle yapısı, örnekler veya açıklama sırası değişebilir. Yaratıcı yazı gibi görevlerde farklılık daha belirgin hale gelebiliyor.
Bu özellik modelin sürekli rastgele cevap verdiği anlamına gelmiyor. Güçlü biçimde belirlenmiş gerçeklerde olasılık dağılımı dar olabilirken açık uçlu sorularda çok sayıda geçerli cevap yolu bulunabiliyor.
Yanıtın çeşitliliği kullanılan model, üretim ayarları ve konuşmanın bağlamı gibi faktörlerden de etkileniyor.
ChatGPT her soruda internete mi bakıyor?
Hayır. ChatGPT’nin temel modeli birçok soruya eğitim sırasında öğrendiği örüntüler ve mevcut konuşma bağlamıyla cevap verebiliyor. Her soruda otomatik olarak Google benzeri bir arama motoruna gidip sonuçları okumak zorunda değil.
Ancak güncel bilgi, internetteki belirli bir sayfa veya son gelişmeler gerektiğinde ChatGPT web aramasını kullanabiliyor. Bu durumda arama sistemi ilgili sonuçları getiriyor ve model bu yeni bilgileri kendi bağlamına dahil ederek cevap oluşturuyor.
Örneğin “TCP nasıl çalışır?” gibi temel bir teknoloji sorusunda web araması her zaman gerekli olmayabilir. “Bugün NVIDIA’nın açıkladığı yeni ekran kartının fiyatı ne?” sorusunda ise güncel internete erişmek cevabın doğruluğu açısından çok daha önemli.
Bu ayrım ChatGPT ile klasik arama motoru arasındaki temel farklardan biri. Arama motoru esas olarak mevcut sayfaları bulurken dil modeli elde ettiği bilgileri kullanarak yeni bir açıklama oluşturuyor.
Web araması yaptığında ne değişiyor?
Web araması gerektiğinde model önce hangi bilgiyi bulması gerektiğini belirliyor ve arama için uygun sorgular oluşturabiliyor. Arama sistemi internetten sonuçlar getiriyor ve model bu sonuçların içeriklerini inceleyerek soruyla ilgili bilgileri ayıklıyor.
Daha sonra bulunan bilgiler normal bağlamın bir parçası haline geliyor. Model hâlâ cevabı token token kendisi oluşturuyor ancak bu kez yalnızca eğitim sırasında öğrendiği bilgilere değil, aramadan gelen güncel verilere de dayanabiliyor.
Bu süreç retrieval augmented generation, yani dışarıdan bilgi getirerek üretim yapma yaklaşımının bir örneği olarak düşünülebilir. Dil modeli ile bilgi erişim sistemi ayrı görevleri yerine getiriyor ve sonuçta tek bir cevapta birleşiyor.
Web aramasının bulunması bütün hataları otomatik olarak ortadan kaldırmıyor. Yanlış kaynak seçimi, güncel olmayan sayfa veya kaynaktaki hatalı bilgi yine cevabı etkileyebileceği için kaynak kalitesi önemini koruyor.
ChatGPT dosyaları nasıl okuyabiliyor?
PDF, Word belgesi, tablo veya başka bir dosya yüklendiğinde ChatGPT dosyanın içeriğini işleyebilen ek sistemlerden yararlanabiliyor. Dosyadaki metin çıkarılabiliyor, tablolar yapılandırılmış biçimde okunabiliyor ve gerekirse görsel içerikler ayrı olarak analiz edilebiliyor.
Model daha sonra dosyadan gelen ilgili parçaları soruyla birlikte değerlendiriyor. Örneğin 100 sayfalık bir raporun belirli bir bölümünü sorarsanız sistem ilgili içeriği bulup modele bağlam olarak sağlayabiliyor.
Elektronik tablolarda ise yalnızca dil modeli kullanılması gerekmiyor. Hesaplama ve veri analizi araçları devreye girerek binlerce satır üzerinde matematiksel işlemler yapılabiliyor ve çıkan sonuç dil modeli tarafından açıklanabiliyor.
Bu nedenle ChatGPT’nin güncel hali yalnızca “metin yazan model” olarak düşünülmemeli. Ürünün kendisi, dil modelinin çevresinde farklı veri kaynaklarını ve araçları kullanabilen daha geniş bir sistem oluşturuyor.
Matematik işlemlerini gerçekten kafasından mı yapıyor?
Basit matematik işlemlerinde dil modeli öğrendiği örüntüler ve akıl yürütme yetenekleriyle doğrudan doğru sonuca ulaşabilir. Ancak büyük sayılar, istatistik, veri analizi veya karmaşık hesaplarda yalnızca token tahminine güvenmek hata ihtimalini artırabilir.
Bu nedenle ChatGPT kullanılabilir olduğunda hesaplama araçlarından yararlanabiliyor. Model problemin hangi işlemleri gerektirdiğini belirliyor, hesaplamayı araç üzerinden yaptırıyor ve sonucu doğal dilde açıklıyor.
Benzer durum kod çalıştırma, dosya dönüştürme veya veri görselleştirme işlemlerinde de geçerli. Dil modeli yapılması gereken görevi planlarken gerçek hesaplama ayrı bir çalışma ortamında gerçekleştirilebiliyor.
Böylece modelin güçlü olduğu dil ve problem çözme tarafıyla bilgisayarın kesin hesap yapma avantajı bir araya getiriliyor.
Görsel gönderildiğinde ChatGPT ne görüyor?
Görsel destekleyen modellerde fotoğraf yalnızca dosya adı veya alternatif metin olarak işlenmiyor. Görüntü modelin işleyebileceği görsel temsillere dönüştürülüyor ve metinle birlikte değerlendirilmek üzere sisteme aktarılıyor.
Model nesneler, yazılar, şekiller, konum ilişkileri ve görüntü içerisindeki diğer özellikler hakkında çıkarım yapabiliyor. Örneğin bir anakart fotoğrafındaki bağlantı noktalarını veya hata ekranındaki mesajı metin sorusuyla birlikte yorumlayabiliyor.
Bu süreç insan gözünün çalışmasıyla aynı değil. Görüntü matematiksel temsillere dönüştürülüyor ve model eğitim sırasında öğrendiği görsel-dil ilişkileri üzerinden yorum oluşturuyor.
Görüntünün çözünürlüğü, okunabilirliği, açı ve içerik karmaşıklığı sonucu etkileyebiliyor. Küçük veya bulanık bir metnin yanlış okunması bu nedenle mümkün.
ChatGPT bir soruyu gerçekten “anlıyor” mu?
Burada “anlamak” kelimesinin ne anlama geldiği önemli. ChatGPT insanın sahip olduğu biyolojik bilinç, kişisel deneyimler veya duyusal yaşam üzerinden anlam oluşturmuyor.
Buna karşılık model dil içerisindeki kavramlar, ilişkiler, neden-sonuç bağlantıları ve bağlam üzerinde oldukça karmaşık işlemler yapabiliyor. Bir metindeki çelişkiyi bulabilir, verilen kuralları yeni örneğe uygulayabilir veya daha önce doğrudan görmediği bir problemi çözmek için öğrendiği ilişkileri birleştirebilir.
Bu davranışlar pratik kullanım açısından “anlama” olarak nitelendirilebilecek sonuçlar oluşturuyor ancak bunun insan zihnindeki anlam deneyimiyle aynı mekanizma olduğunu söylemek için bilimsel temel bulunmuyor.
Dil modellerinin iç temsillerinin ne ölçüde kavramsal modeller oluşturduğu da aktif araştırma konularından biri olmaya devam ediyor.
ChatGPT neden bazen çok emin şekilde yanlış cevap veriyor?
Modelin temel görevi dil açısından uygun ve bağlama uyan token dizileri üretmek. Üretilen cümlenin akıcı ve ikna edici olması, içerisindeki her iddianın gerçek dünyada doğru olduğunu otomatik olarak garanti etmiyor.
Bir konuda yeterli bilgi bulunmadığında model öğrenmiş olduğu dil kalıplarından son derece makul görünen ancak yanlış bir detay üretebilir. Buna genellikle hallucination, yani halüsinasyon adı veriliyor.
Özellikle düşük frekanslı gerçekler, çok yeni olaylar, kesin tarih veya sayı isteyen sorular ve doğrulanması zor özel bilgiler bu riski artırabiliyor. Model bazen gerçekte bulunmayan bir kitap, araştırma veya özellik adı dahi oluşturabilir.
Web araması, dış kaynak kullanımı ve daha gelişmiş reasoning sistemleri bu hataları azaltabiliyor ancak tamamen ortadan kaldırmıyor. Bu nedenle yüksek önem taşıyan bilgilerin doğrulanması hâlâ gerekli.
Neden “bilmiyorum” demek yerine cevap uydurabiliyor?
Dil modellerinin ilk eğitim aşamasında temel hedef, mevcut metne uygun sonraki tokenı tahmin etmek. Eğitim verilerindeki cümleler genellikle doğru veya yanlış şeklinde ayrı etiketlerle sunulmuyor ve model akıcı dil örüntülerini öğreniyor.
OpenAI’nin halüsinasyonlar üzerine yayımladığı araştırmalarda da yalnızca doğru cevap sayısını ödüllendiren değerlendirmelerin, modelin belirsiz olduğu durumlarda tahmin yürütmesini teşvik edebildiği belirtiliyor. Yanlış tahmin bazen puan kazandırabilirken “bilmiyorum” cevabı hiçbir zaman doğru cevap puanı getirmeyebiliyor.
Yeni nesil modeller belirsizlik belirtme ve gerektiğinde cevap vermekten kaçınma konusunda ayrıca eğitiliyor. Buna rağmen gerçek dünyadaki bütün sorularda modelin kendi bilgisinin sınırını kusursuz biçimde belirlemesi henüz çözülebilmiş bir problem değil.
Bu nedenle çok spesifik bir konuda son derece kesin bir cevap görmek, cevabın otomatik olarak doğru olduğu anlamına gelmiyor.
Eğitim bittikten sonra model yeni şeyleri öğreniyor mu?
Bir dil modelinin temel parametreleri normal sohbet sırasında her kullanıcı mesajıyla anında yeniden eğitilmiyor. Bir soru sorduğunuzda modelin milyarlarca parametresi o konuşmaya göre kalıcı olarak yeniden yazılmıyor.
Sohbet içerisindeki yeni bilgiler bağlam üzerinden kullanılabiliyor. Örneğin “Benim arabam 2018 model” dediğinizde model birkaç mesaj sonra bunu konuşmanın bağlamından hatırlayabilir ancak bu durum modelin temel ağırlıklarının eğitilmesiyle aynı şey değil.
ChatGPT ürününde bellek özelliği de kullanılabiliyor. Bellek etkin olduğunda geçmiş konuşmalardan veya diğer uygun kaynaklardan ilgili tercihler ve bilgiler gelecekteki konuşmalarda bağlama eklenebiliyor.
Bu da temel model eğitimiyle aynı işlem değil. Modelin parametrelerinin değiştirilmesi yerine ilgili kişisel bilgi yeni cevap oluşturulurken modele ek bağlam olarak sunuluyor.
ChatGPT geçmiş konuşmaları nasıl hatırlayabiliyor?
Aynı sohbet içerisinde önceki mesajlar bağlamın parçası olarak kullanılabiliyor. Böylece kullanıcı sürekli olarak konunun tamamını yeniden açıklamak zorunda kalmıyor.
ChatGPT’nin bellek sistemi açık olduğunda ise geçmiş konuşmalardan uzun vadede yararlı olabilecek bilgiler ayrıca sentezlenebiliyor. Sistem her cümleyi birebir sonsuza kadar hatırlamak yerine gelecekteki konuşmalarda yararlı olabilecek bilgileri seçmeye çalışıyor.
Bu nedenle bellek, insan hafızasının dijital kopyası gibi düşünülmemeli. İlgili bağlam gerektiğinde gelecekteki isteğe eklenebilen ayrı bir ürün katmanı olarak çalışıyor.
Aynı sebeple modelin “hatırladığı” bir bilgi, temel modelin eğitim parametrelerinde özel olarak kullanıcıya ait yeni bilgi bulunduğu anlamına gelmiyor.
ChatGPT talimatlar arasında nasıl seçim yapıyor?
Bir ChatGPT konuşmasında yalnızca kullanıcının son mesajı bulunmuyor. Ürün davranışını belirleyen farklı seviyelerde talimatlar, güvenlik kuralları ve konuşma bağlamı da modele sağlanabiliyor.
Model çelişen talimatlar bulunduğunda öncelik sırasına göre hareket edecek şekilde tasarlanıyor. Kullanıcının yazdığı komutlar normalde cevabı doğrudan şekillendirirken daha yüksek öncelikli güvenlik veya sistem kurallarıyla çelişen talepler uygulanmayabiliyor.
Bu mekanizma modelin her kullanıcının gönderdiği metni koşulsuz olarak yerine getirmemesini sağlıyor. Aynı zamanda biçim, dil ve cevap tarzı gibi kullanıcı tercihleri uyumlu oldukları sürece cevaba yansıtılabiliyor.
Kullanıcı tarafında görünmeyen bütün iç talimatları bilmek veya bunları doğrudan değiştirmek mümkün değil. Ürün güvenliği ve sistem davranışı için bazı talimat katmanları kullanıcı mesajından bağımsız olarak bulunuyor.
Reasoning modeli ile normal model arasında ne fark var?
Bazı modeller hızlı ve doğrudan cevap üretmeye odaklanırken reasoning modelleri görünür yanıtı oluşturmadan önce problem üzerinde daha fazla hesaplama yapabiliyor. OpenAI’nin güncel reasoning modellerinde bu işlem için görünür cevap tokenlarından ayrı iç reasoning tokenları kullanılabiliyor.
Bu modeller karmaşık matematik, kodlama, bilimsel analiz veya çok aşamalı görevlerde problemi alt parçalara ayırıp farklı seçenekleri değerlendirebiliyor. Daha fazla hesaplama kullanılması cevap süresini uzatabilir ancak zor problemlerde doğruluğu artırabilir.
Her soru uzun reasoning gerektirmiyor. “HDMI neyin kısaltması?” gibi doğrudan bir bilgi sorusuyla karmaşık bir yazılım hatasının analiz edilmesi aynı hesaplama ihtiyacına sahip değil.
ChatGPT kullanılan modele ve ürün ayarlarına bağlı olarak zor görevlerde daha fazla düşünme süresi kullanabiliyor. Kullanıcı nihai cevabı görürken modelin ham iç reasoning sürecinin tamamı doğrudan gösterilmiyor.
ChatGPT cevap üretirken önce plan yapıyor mu?
Basit sorularda ayrı ve uzun bir plan oluşturulması gerekmeyebilir. Model doğrudan uygun cevabı üretmeye başlayabilir ve bağlam ilerledikçe yanıtın yapısını sürdürebilir.
Daha karmaşık görevlerde ise reasoning sistemi problemi bölümlere ayırabilir, ihtiyaç duyduğu bilgileri belirleyebilir, araç çağrıları yapabilir ve sonuçları yeniden değerlendirebilir. Örneğin güncel bir ürün karşılaştırmasında önce teknik özellikleri aramak, daha sonra fiyatları doğrulamak ve ardından karşılaştırmayı yazmak gerekebilir.
Buradaki planlama klasik bir programda önceden yazılmış sabit algoritma olmak zorunda değil. Model görevin içeriğine göre hangi adımların gerekli olduğuna dinamik biçimde karar verebiliyor.
Bu yetenek ChatGPT’nin yalnızca tek mesajlık soru-cevap sisteminden çıkıp çok aşamalı işleri gerçekleştirebilmesinin temel parçalarından biri.
Bir aracı ne zaman kullanacağına nasıl karar veriyor?
ChatGPT’ye kullanılabilecek araçların açıklamaları ve hangi durumlarda kullanılabilecekleri sağlanabiliyor. Model soruyu değerlendirirken normal metin cevabı yerine ilgili aracı çağırmanın daha uygun olduğuna karar verebilir.
Örneğin güncel hava durumu sorulduğunda hava durumu kaynağına, karmaşık matematikte hesaplama aracına veya yüklenmiş bir dosyayla ilgili soruda dosya sistemine başvurabilir. Araçtan dönen sonuç daha sonra yeniden modelin bağlamına giriyor.
Model son cevabı bu veriyi kullanarak yazıyor. Dolayısıyla kullanıcı tek bir sohbet görüyor olsa da arka planda birkaç farklı sistemin sırayla çalıştığı bir işlem zinciri bulunabiliyor.
Her aracın erişebildiği bilgi ve yapabildiği işlem farklı. Model kendi başına internetteki veya kullanıcının cihazındaki her şeye sınırsız erişime sahip değil.
ChatGPT cevabın doğru olup olmadığını tekrar kontrol ediyor mu?
Bu durum kullanılan model, görev ve araçlara bağlı. Reasoning modelleri cevabı üretmeden önce farklı olasılıkları değerlendirebilir ve bazı görevlerde araçlardan alınan sonuçları karşılaştırabilir.
Web araştırması gereken bir konuda birden fazla kaynak kontrol edilebilirken matematik problemi hesaplama aracıyla doğrulanabilir. Kod yazıldığında çalışma ortamında kodu çalıştırarak hata olup olmadığı test edilebilir.
Ancak her sıradan cevap otomatik olarak bağımsız bir ikinci sistem tarafından baştan sona doğrulanmıyor. Model bir yanıtı son derece akıcı biçimde üretirken içerisindeki küçük bir ayrıntının yanlış olması hâlâ mümkün.
Bu nedenle özellikle sağlık, hukuk, finans, güvenlik veya güncel olaylar gibi yüksek doğruluk gerektiren konularda kaynak doğrulaması ve gerektiğinde uzman değerlendirmesi önemini koruyor.
Modelin “bilgisi” nerede tutuluyor?
Temel model açısından bilginin büyük bölümü ağırlıklar veya parametreler adı verilen sayısal değerlerin oluşturduğu yapıya dağılmış durumda. Bu parametreler yapay sinir ağındaki hesaplamaların nasıl gerçekleşeceğini belirliyor.
Bir kavram yalnızca tek bir parametrede saklanmıyor. “Paris Fransa’nın başkentidir” gibi basit görünen bilgi bile çok sayıda katman ve parametre üzerinden ortaya çıkan ilişkilerin parçası olabilir.
Bu yüzden bir dil modelini geleneksel veritabanıyla karşılaştırmak yanıltıcı. Veritabanında belirli kayıt doğrudan bulunup okunabilirken sinir ağında bilgi çok daha dağıtılmış ve dolaylı şekilde temsil ediliyor.
Web araması, dosyalar ve bellek gibi dış sistemler ise bu parametrelerden ayrı. Bunlar gerektiğinde modele yeni bağlam sağlayan bilgi kaynakları olarak çalışıyor.
ChatGPT internette olmayan yeni bir fikir üretebilir mi?
Model eğitim sırasında öğrendiği kavramları yeni biçimlerde birleştirebilir ve eğitim verisinde birebir bulunmayan metinler oluşturabilir. Yeni bir hikâye, farklı bir ürün fikri veya belirli koşullara göre hazırlanmış kod bu yeteneğin örnekleri arasında.
Bu tür üretim tamamen yoktan bağımsız bilgi yaratıldığı anlamına gelmiyor. Modelin kullanabildiği kavramlar ve ilişkiler eğitim sırasında öğrendiği temellerden ortaya çıkıyor.
İnsanların da daha önce öğrendiği kavramları yeni biçimlerde bir araya getirmesine benzer bir sonuç ortaya çıkabilse de altında çalışan mekanizma biyolojik yaratıcılıkla aynı değil.
Modelin yeni kombinasyonlar oluşturabilmesi özellikle tasarım, yazılım ve fikir üretimi gibi açık uçlu görevlerde güçlü sonuçlar verebiliyor.
ChatGPT’nin cevabı neden bazen soru uzadıkça değişiyor?
Her yeni kullanıcı mesajı modele yeni bağlam ekliyor. Kullanıcı bir koşulu düzelttiğinde veya ek bilgi verdiğinde cevap oluşturulurken kullanılan veri de değişiyor.
Örneğin “Bana 50.000 TL bütçeyle bilgisayar öner” dedikten sonra “Ama yalnızca mini-ITX olsun” demek seçenekleri ciddi biçimde değiştiriyor. Model ikinci cevapta ilk isteği ve yeni kısıtı birlikte değerlendirmek zorunda.
Uzun sohbetlerde daha önce verilen bilgilerin birbiriyle çelişmesi de sonuçları etkileyebilir. Güncel veya daha açık belirtilen bilgi genellikle daha anlamlı hale gelirken ürün tarafındaki bağlam yönetimi hangi mesajların modele sunulduğunu da belirleyebilir.
Bu nedenle iyi hazırlanmış ve açık bir soru, modelin daha doğru cevap üretmesini kolaylaştırıyor.
İyi prompt gerçekten fark yaratıyor mu?
Evet, çünkü model cevabı verilen bağlama göre oluşturuyor. “Bir işlemci anlat” ile “Ryzen 9 9950X’in mimarisini teknik ancak yeni başlayanların anlayacağı şekilde anlat” aynı miktarda yönlendirme sağlamıyor.
Ama iyi prompt yazmak için uzun ve karmaşık komutlara her zaman ihtiyaç yok. Asıl önemli olan amaç, gerekli bağlam ve kısıtların açık olması.
İstenen çıktı biçimi, hedef kitle veya kullanılmaması gereken bilgiler belirtilirse model olası cevaplar arasındaki alanı daraltabiliyor. Böylece sonuç kullanıcının beklentisine daha yakın hale geliyor.
Belirsiz bir soruda ise model eksik noktaları kendi varsayımlarıyla doldurmak zorunda kalabilir ve bu da istenmeyen cevap ihtimalini artırabilir.
ChatGPT neden bazen uzun düşünüyor?
Sorunun zorluğu ve kullanılan model cevabın hazırlanma süresini değiştirebiliyor. Basit bir tanım birkaç hesaplama adımıyla üretilebilirken karmaşık kod analizi veya çok kaynaklı araştırma daha fazla işlem gerektiriyor.
Reasoning modelleri görünür cevaptan önce yüzlerce veya binlerce iç reasoning tokenı kullanabiliyor. Araç kullanılması durumunda web araması, dosya okuma veya hesaplama işlemlerinin tamamlanması da ek süre yaratıyor.
Daha uzun bekleme her zaman daha doğru cevap anlamına gelmiyor ancak zor problemlerde ek hesaplama modelin seçenekleri daha ayrıntılı değerlendirmesine yardımcı olabiliyor.
Bu yüzden ChatGPT’nin birkaç saniye boyunca cevap vermemesi sistemin donduğu anlamına gelmek zorunda değil. Arka planda ek reasoning veya araç kullanımı gerçekleşiyor olabilir.
ChatGPT’nin cevabı ekrana nasıl geliyor?
Model ilk görünür tokenları üretmeye başladığında sistem bunları kullanıcı arayüzüne aktarabiliyor. Böylece bütün cevap tamamlanana kadar beklemek yerine metnin oluşumunu anlık olarak görebiliyorsunuz.
Bu yönteme streaming adı veriliyor. Sunucuda üretilen tokenlar küçük parçalar halinde istemciye gönderiliyor ve tarayıcı veya uygulama bunları ekranda gösteriyor.
Bu nedenle bir paragraf ekrana geldikten sonra model hâlâ sonraki bölüm üzerinde çalışıyor olabilir. Uzun cevaplarda yazının birkaç saniye boyunca aşamalı biçimde oluşmasının nedeni bu.
Araç kullanılması gereken görevlerde ise görünür metin üretimi geçici olarak durabilir ve araç sonucu geldikten sonra cevap devam edebilir.
ChatGPT aslında bir modelden daha fazlası
ChatGPT ile onu çalıştıran temel yapay zekâ modelini tamamen aynı kavram olarak görmek doğru değil. Model, metin ve diğer girdileri işleyerek çıktı üreten temel yapay zekâ bileşeni; ChatGPT ise bunun çevresinde oluşturulmuş ürün.
Ürün içerisinde sohbet geçmişi, bellek, web araması, dosya analizi, görsel işleme, araç kullanımı ve farklı güvenlik sistemleri bulunabiliyor. Hangi özelliklerin kullanılabildiği kullanılan plan, model, platform ve bölgeye göre değişebiliyor.
Bu nedenle ChatGPT’nin verdiği bir cevap bazen tamamen modelin mevcut bağlamından, bazen güncel web araştırmasından, bazen de kullanıcının yüklediği özel bir dosyadan oluşan bilgiyle hazırlanabiliyor.
Kullanıcı açısından tek bir mesaj kutusu görünse de arkasında dil modeli, bilgi erişim sistemleri ve gerektiğinde farklı araçların birlikte çalıştığı daha kapsamlı bir mimari bulunuyor.
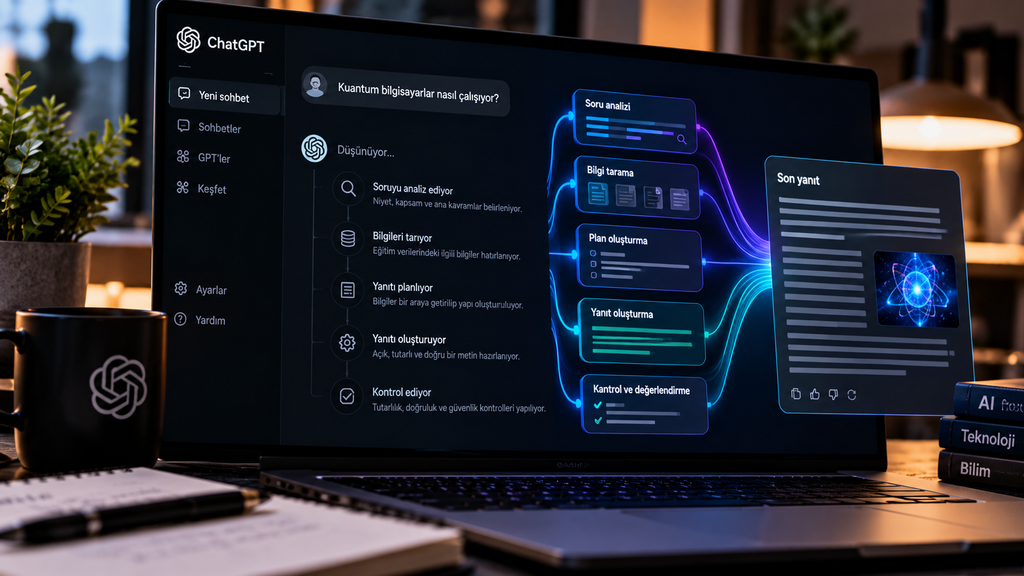
Bir soru gönderildiğinde saniyeler içinde neler oluyor?
Sorunuz gönderildikten sonra metin tokenlara ayrılıyor ve konuşmanın ilgili bağlamıyla birlikte modele hazırlanıyor. Model tokenlar arasındaki ilişkileri sinir ağının katmanları üzerinden işliyor ve sorunun ne istediğine ilişkin bir temsil oluşturuyor.
Görev dış bilgi gerektiriyorsa uygun bir araç kullanılabiliyor ve elde edilen veri yeniden bağlama ekleniyor. Reasoning gereken bir görevde model görünür cevaptan önce ek hesaplama yapabiliyor.
Ardından model ilk çıktı tokenı için olasılıkları hesaplıyor, uygun tokenı seçiyor ve aynı işlemi yeni bağlamla tekrar ediyor. Bu döngü cevap tamamlanana veya sistemin belirlediği çıkış koşullarından biri gerçekleşene kadar devam ediyor.
Ekranda gördüğümüz doğal dildeki birkaç paragrafın arkasında bu nedenle çok sayıda matris işlemi, sinir ağı katmanı, token tahmini ve bazı durumlarda harici araç çağrıları bulunuyor.
ChatGPT cevabı “biliyor” mu, yoksa tahmin mi ediyor?
Teknik açıdan görünür cevabın her tokenı olasılık tahminleri üzerinden oluşturuluyor. Ancak bu tahminler rastgele kelime seçmekten çok uzak; eğitim sırasında öğrenilen son derece büyük ve karmaşık bir ilişki ağına dayanıyor.
Bir bilgi sorusunda doğru cevabın olasılığı model için çok yüksek olabilir. Karmaşık veya belirsiz bir konuda ise birden fazla olası cevap yolu bulunabilir ve hata ihtimali artar.
Bu yapı ChatGPT’nin neden hem son derece güçlü hem de zaman zaman şaşırtıcı şekilde yanlış olabildiğini açıklıyor. Aynı sistem bir programlama hatasını analiz edebilir, uzun raporu özetleyebilir ve karmaşık kavramları açıklayabilirken nadir bir tarihi ayrıntıda güvenle yanlış bilgi verebilir.
ChatGPT’nin nasıl çalıştığını anlamanın en önemli noktası da burada bulunuyor: ekrandaki cevap önceden saklanmış bir metin değil. Soru, mevcut bağlam, modelin öğrendiği parametreler ve gerektiğinde dış araçlardan gelen bilgiler kullanılarak o anda adım adım oluşturuluyor.
