
ChatGPT’ye bir soru yazdığınızda birkaç saniye içinde uzun bir cevap alabiliyor, telefonunuz bir fotoğraftaki nesneleri tanıyabiliyor veya yapay zeka yalnızca birkaç kelimeden gerçekçi bir görüntü üretebiliyor.
Dışarıdan bakıldığında bunların arkasında insan gibi düşünen dijital bir zihin varmış izlenimi oluşabiliyor. Gerçekte modern yapay zeka sistemleri çok büyük miktarda veriden örüntüler öğrenen, bu örüntüleri matematiksel olarak temsil eden ve yeni bir giriş geldiğinde öğrendikleri ilişkiler üzerinden çıktı üreten modellerden oluşuyor.
Yapay zeka tek bir teknoloji değil
Yapay zeka oldukça geniş bir kavram. Görüntü tanıma, konuşmayı yazıya dönüştürme, öneri sistemleri, otonom sürüş, dolandırıcılık tespiti, görüntü üretimi ve büyük dil modelleri aynı başlık altında toplanabiliyor ancak hepsi aynı şekilde çalışmıyor.
Bugün günlük hayatta en fazla karşılaştığımız üretken yapay zeka sistemlerinin önemli bölümü derin öğrenmeye dayanıyor. ChatGPT benzeri dil modelleri metin ve diğer veri türleri arasındaki karmaşık ilişkileri öğrenirken görüntü modelleri pikseller, şekiller, renkler ve görsel kavramlar arasındaki bağlantıları öğreniyor. Aynı temel yaklaşım farklı veri türlerine uygulanabiliyor.
Bu sistemlerde geliştirici tek tek “kedi böyle görünür”, “Paris Fransa’nın başkentidir” veya “bu cümleden sonra şu kelime gelmeli” şeklinde milyonlarca kural yazmıyor. Model, eğitim verisini işleyerek hangi özelliklerin ve ilişkilerin önemli olduğunu kendi parametreleri içinde oluşturuyor.
Sinir ağı nedir?
Modern yapay zekanın temelinde yapay sinir ağları bulunuyor. İsim biyolojik beyinden esinlenmiş olsa da bilgisayardaki yapay nöronlar gerçek beyin hücrelerinin birebir dijital kopyaları değil. Bunlar temel olarak sayıları alan, üzerlerinde matematiksel işlemler yapan ve sonucu bir sonraki katmana aktaran hesaplama birimleri.
Basit bir sinir ağında giriş verileri bir dizi katmandan geçiriliyor. Her bağlantının “ağırlık” adı verilen sayısal bir değeri bulunuyor ve modelin davranışı büyük ölçüde bu değerlerle belirleniyor. Eğitim sırasında sistem doğru sonuçlara yaklaşabilmek için milyonlarca veya milyarlarca ağırlığı küçük miktarlarda değiştiriyor.
Derin öğrenmedeki derin ifadesi de bu yapıdan geliyor. Çok sayıda işlem katmanının üst üste kullanılması, modelin son derece karmaşık ilişkileri temsil edebilmesine imkan veriyor. Günümüzde büyük modellerde parametre sayısı milyarlar seviyesine çıkabiliyor.
Yapay zeka nasıl öğreniyor?
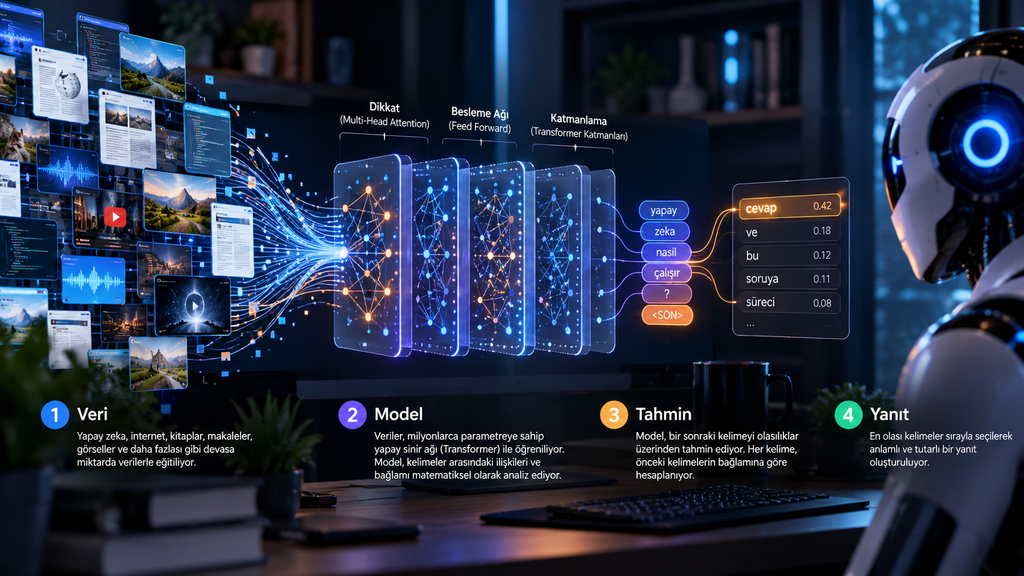
Bir yapay zeka modelinin eğitiminde önce ona çok büyük miktarda veri gösteriliyor. Bir dil modeli için bu veri kitaplar, makaleler, internet metinleri, kod, soru-cevap örnekleri ve lisanslı veya özel olarak hazırlanmış veri setlerinden oluşabiliyor. Model bu metinleri ezberlemek amacıyla değil, içerisindeki dilsel ve kavramsal ilişkileri öğrenmek için işliyor.
Eğitim sırasında modelden genellikle eksik veya sonraki parçayı tahmin etmesi isteniyor. Örneğin “Türkiye’nin başkenti…” şeklindeki bir metinde sistem sonraki parçanın “Ankara” olması gerektiğini başlangıçta bilmiyorsa bir tahmin üretiyor. Tahmin gerçek eğitim örneğiyle karşılaştırılıyor ve hata miktarı hesaplanıyor.
Ardından geri yayılım adı verilen yöntemle modelin hangi parametrelerinin hataya ne ölçüde katkıda bulunduğu belirleniyor. Optimizasyon algoritması milyonlarca küçük ayarlama yaparak modelin bir sonraki denemede doğru cevaba biraz daha yaklaşmasını sağlıyor. Bu işlem devasa veri kümeleri üzerinde tekrar tekrar gerçekleştiriliyor.
Tek bir örnek modele anlamlı bir bilgi kazandırmak için genellikle yeterli değil. Asıl yetenek, çok büyük miktarda örnek işlendiğinde kelimeler, kavramlar, biçimler, programlama yapıları ve farklı bilgi parçaları arasındaki ilişkilerin modelin parametrelerine dağılmış biçimde yerleşmesiyle ortaya çıkıyor.
Büyük dil modelleri kelimeleri doğrudan görmüyor
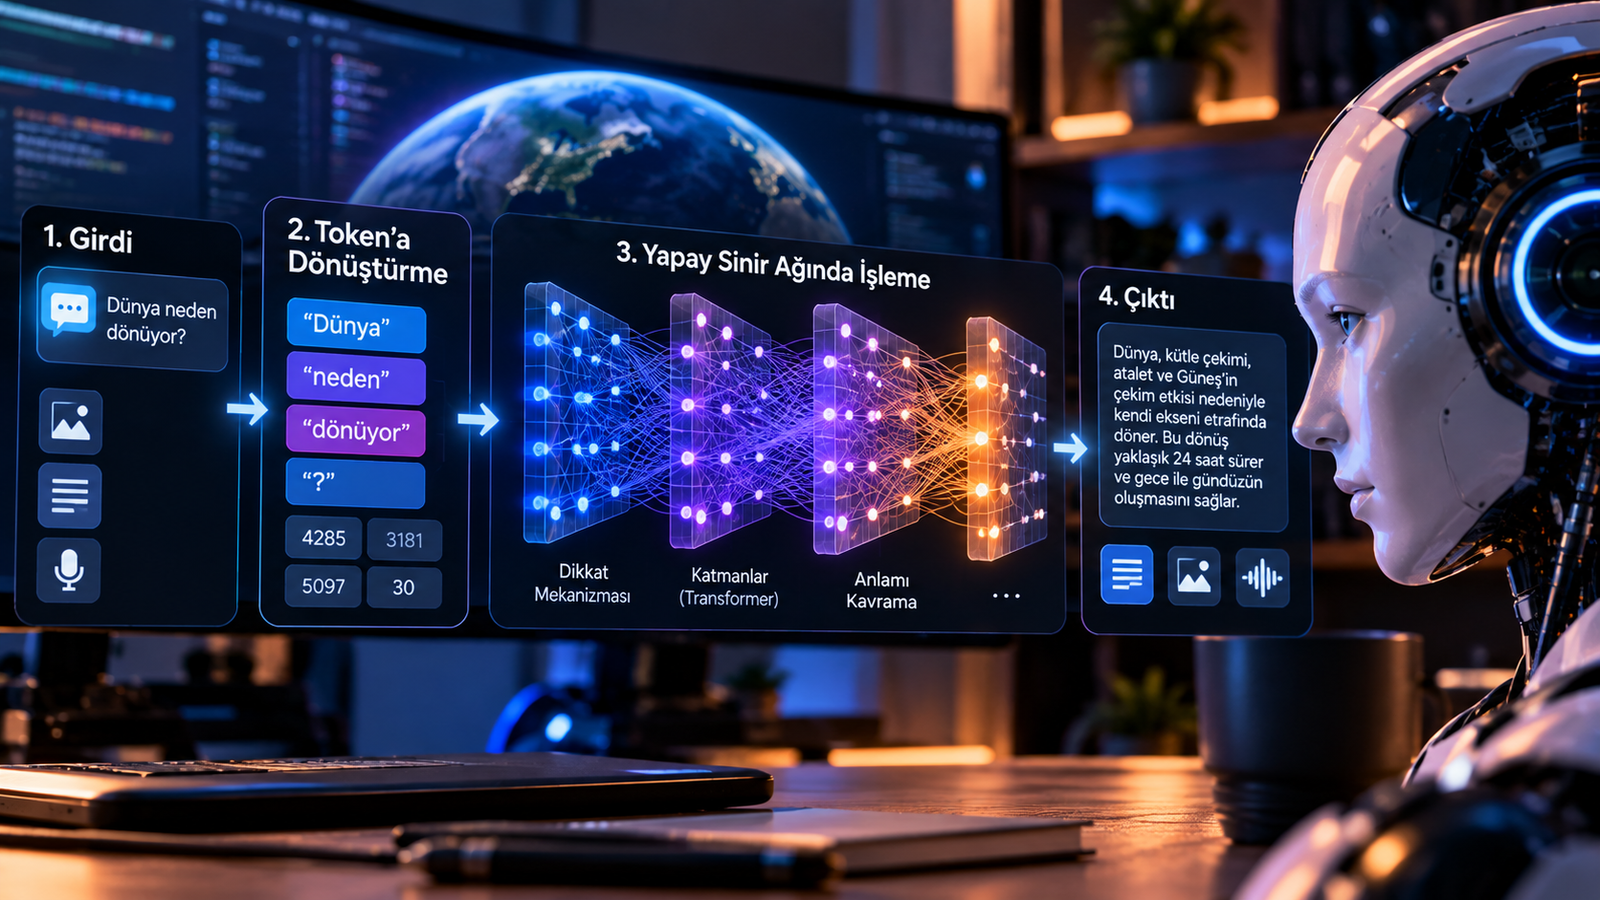
ChatGPT benzeri büyük dil modellerine yazılan metin doğrudan kelime kelime işlenmiyor. Önce metin “token” adı verilen daha küçük parçalara ayrılıyor. Bir token tek bir kelime olabileceği gibi kelimenin bir bölümü, noktalama işareti veya bazı durumlarda birkaç karakterden oluşan bir parça da olabiliyor.
Örneğin uzun bir Türkçe kelime model tarafından birden fazla tokena ayrılabilir. Model açısından giriş başlangıçta harflerden veya kelimelerden çok, bu tokenları temsil eden sayısal kimliklerden oluşuyor. Ardından her token yüksek boyutlu bir matematiksel temsile dönüştürülüyor.
Bu temsillere embedding adı veriliyor. Birbirleriyle ilişkili kavramların matematiksel uzaydaki temsilleri de belirli yönlerden birbirine yakınlaşabiliyor. Model böylece yalnızca kelimelerin yazılışını değil, kullanım bağlamlarındaki ilişkileri de işleyebiliyor.
Transformer yapısı neden bu kadar önemli?
Bugünkü büyük dil modellerinin temelini büyük ölçüde Transformer mimarisi oluşturuyor. Transformer’ın en önemli özelliklerinden biri, bir cümledeki veya daha uzun bir metindeki farklı parçaların birbirleriyle olan ilişkilerini aynı anda değerlendirebilmesi.
Bunun merkezinde “attention”, yani dikkat mekanizması bulunuyor. Model bir tokenı işlerken bağlamdaki diğer tokenların hangilerinin o anda daha önemli olduğuna farklı ağırlıklar verebiliyor. Böylece bir kelimenin anlamı yalnızca hemen yanındaki kelimelerden değil, metnin daha uzak bölümlerinden de etkilenebiliyor.
Örneğin “Ali telefonu masaya bıraktı çünkü o çok ağırdı” gibi bir cümlede “o” kelimesinin neye işaret ettiğini anlamak için cümlenin farklı bölümleri arasındaki ilişkiyi değerlendirmek gerekiyor. Transformer katmanları bu tür ilişkileri tek bir basit kuralla değil, eğitim sırasında öğrenilmiş çok sayıda matematiksel örüntü üzerinden işliyor.
Modern modellerde bu işlem bir kez yapılmıyor. Çok sayıda Transformer katmanı boyunca temsil tekrar tekrar dönüştürülüyor. İlk katmanlarda daha basit dil ilişkileri işlenirken ilerleyen katmanlarda daha karmaşık kavramsal bağlantılar ortaya çıkabiliyor.
ChatGPT cevap verirken aslında ne yapıyor?
Bir dil modeline soru gönderildiğinde eğitim yeniden başlamıyor. Model, eğitim sırasında oluşturulmuş parametrelerini kullanarak “inference” adı verilen çıkarım sürecine geçiyor. Kullanıcının mesajı tokenlara ayrılıyor, model bunları işliyor ve sıradaki token için olası seçeneklerin olasılıklarını hesaplıyor.
Örneğin bir noktada “Ankara” tokenının olasılığı yüzde 70, “İstanbul” yüzde 10 ve başka seçeneklerin toplamı yüzde 20 olabilir. Sistem seçilen üretim ayarlarına göre bu dağılımdan bir sonraki tokenı belirliyor. Ardından yeni token da bağlama ekleniyor ve işlem tekrar gerçekleştiriliyor.
Bu süreç cevap bitene kadar devam ediyor. Uzun bir paragraf tek hamlede oluşturulmuyor; model metni adım adım üretiyor. Her yeni token, daha önce yazılmış bütün ilgili bağlamın üzerine ekleniyor.
Buradaki “sonraki tokenı tahmin etme” ifadesi sistemin basit bir otomatik tamamlama aracı olduğu anlamına gelmiyor. Milyarlarca parametreli modelin doğru sonraki tokenı tahmin edebilmesi için dil bilgisi, kavram ilişkileri, kod yapıları, metin türleri ve çok sayıda problem çözme örüntüsünü temsil etmesi gerekiyor.
Peki model bilgileri nerede saklıyor?
Büyük dil modellerinde bilgiler klasik bir veri tabanındaki satırlar gibi tutulmuyor. “Türkiye’nin başkenti = Ankara” şeklinde tek bir hücre bulunup sorulduğunda oradan okunmuyor. Öğrenilen ilişkiler modelin çok sayıdaki parametresine dağılıyor.
Bu nedenle modelin belirli bir bilgiyi tam olarak hangi parametrede tuttuğunu göstermek genellikle mümkün değil. Aynı parametre birçok farklı görevde rol oynayabiliyor ve tek bir kavram da çok sayıda parametrenin ortak çalışmasıyla temsil edilebiliyor.
Bu yapı modellerin öğrendikleri bilgiler arasında bağlantı kurabilmesini sağlıyor ancak aynı zamanda önemli bir sınırlama getiriyor. Model bir veri tabanı gibi “bulduğu kaydı” göstermediği için gerçeğe benzeyen fakat yanlış bir cevabı da matematiksel olarak makul bulup üretebiliyor.
Yapay zeka neden halüsinasyon görüyor?
Üretken yapay zeka sistemlerinde “halüsinasyon”, modelin gerçekte var olmayan veya yanlış bir bilgiyi güvenilir bir dille üretmesi için kullanılan terim. Bunun temel nedenlerinden biri, dil modelinin görevini doğrudan “gerçeği veri tabanından bulmak” şeklinde yerine getirmemesi.
Model bağlama uygun ve olası bir cevap oluşturuyor. Eğitim sırasında benzer yapıdaki metinlerde belirli bir isim, tarih veya kaynak biçimi gördüyse gerçek olmayan bir ayrıntıyı da aynı yapıya uygun biçimde üretebilir. Dil açısından kusursuz görünen bir cümle bu nedenle bilgi açısından yanlış olabilir.
Güncel sistemlerde web araması, harici veri tabanları, kod çalıştırma, hesap makinesi ve farklı doğrulama araçlarının modele bağlanmasının önemli nedenlerinden biri bu. Model yalnızca kendi parametrelerindeki bilgiyle cevap vermek yerine gerekli durumlarda güncel veya doğrulanabilir veriyi dış kaynaktan alabiliyor.
Buna rağmen harici araç kullanılması bütün hata ihtimalini ortadan kaldırmıyor. Model kaynağı yanlış yorumlayabilir, iki farklı bilgiyi birleştirebilir veya belirsiz bir veriden kesin sonuç çıkarabilir. Kritik bilgilerin ayrıca doğrulanması bu yüzden önemini koruyor.
Model internette arama mı yapıyor?
Her yapay zeka cevabı sırasında otomatik olarak internette arama yapılmıyor. Bir modelin temel bilgi birikimi büyük ölçüde eğitim sırasında öğrendiği parametrelerde bulunuyor. Eğer sisteme web arama aracı bağlanmışsa güncel bilgi gerektiğinde ayrıca internete erişebiliyor.
Bu iki çalışma biçimi birbirinden farklı. Model yalnızca kendi eğitilmiş bilgisini kullanıyorsa cevap için canlı bir internet sitesine bağlanması gerekmiyor. Web erişimi kullanıldığında ise arama sonuçları veya açılan sayfalar modele ek bağlam olarak veriliyor ve cevap bu bilgiler de hesaba katılarak hazırlanıyor.
Benzer biçimde yapay zekaya hesap makinesi, kod çalıştırma ortamı veya kurumsal veri tabanı bağlanabiliyor. Böylece modelin dil üretme yeteneği dış araçların daha kesin hesaplama ve veri erişim özellikleriyle birleştiriliyor.
Eğitim bittikten sonra model neden ayrıca eğitiliyor?
Temel eğitim tamamlandığında ortaya çıkan model dili güçlü biçimde öğrenmiş olsa da kullanıcıya faydalı cevap vermek için henüz yeterince yönlendirilmiş olmayabilir. Bu nedenle büyük modeller genellikle ikinci bir eğitim aşamasından geçiriliyor.
Bu süreçte soru-cevap örnekleri, insan tercihleri, güvenlik kuralları ve çeşitli görevler üzerinden modelin davranışı düzenleniyor. Farklı geliştiriciler bunun için denetimli ince ayar, tercih optimizasyonu ve pekiştirmeli öğrenme gibi yöntemlerin farklı kombinasyonlarını kullanabiliyor.
Örneğin temel model verilen metni tamamlamaya daha yatkınken son kullanıcıya sunulan sohbet modeli soruları cevaplamayı, talimatları takip etmeyi ve konuşmanın önceki bölümlerini dikkate almayı öğreniyor. Modelin bilgi kapasitesi ile nasıl davranacağı aynı eğitim aşamasında belirlenmek zorunda değil.
“Reasoning” yapan yapay zeka farklı mı çalışıyor?
Son yıllarda yaygınlaşan reasoning, yani muhakeme odaklı modeller aynı temel yapay zeka altyapısının üzerine daha fazla çıkarım zamanı ve farklı eğitim yöntemleri ekleyebiliyor. Sistem bazı problemlerde cevabı hemen vermek yerine daha fazla hesaplama yaparak ara ilişkileri değerlendirebiliyor.
Bu yaklaşım özellikle matematik, yazılım geliştirme, bilimsel problemler ve çok aşamalı görevlerde performansı yükseltebiliyor. Modelin eğitimden sonra kullandığı hesaplama miktarının artırılması, yalnızca daha büyük modeller üretmenin dışında performansı artırmanın önemli yollarından biri haline geldi.
Ancak daha fazla hesaplama her sorunun doğru cevaplanacağını garanti etmiyor. Yanlış bir varsayım üzerinden ilerleyen model daha uzun işlem yaptıktan sonra yine hatalı bir sonuç oluşturabilir.
Yapay zeka görüntüleri nasıl tanıyor?
Görüntü modellerinde temel fikir metinden farklı görünse de yine sayısal temsiller üzerinden çalışılıyor. Bilgisayar açısından fotoğraf başlangıçta milyonlarca piksel ve bunların renk değerlerinden oluşan büyük bir sayı dizisi.
Model eğitim sırasında kenarlar, dokular, şekiller, nesne parçaları ve giderek daha karmaşık görsel kavramlar arasındaki ilişkileri öğreniyor. Yeterli miktarda örnek işlendiğinde “kedi” kavramı belirli piksel dizilerinin ezberlenmesinden çok farklı görünüşlerdeki kedilerde ortaklaşan görsel özelliklerle temsil edilebiliyor.
Modern multimodal modeller görüntüyü doğrudan dil modeliyle ilişkilendirilebilecek sayısal temsillere çevirebiliyor. Böylece aynı sistem bir fotoğraftaki nesneyi tanımlayabiliyor, grafik okuyabiliyor, ekran görüntüsündeki yazıyı yorumlayabiliyor veya görüntü hakkında sorulara cevap verebiliyor.
Yapay zeka sıfırdan görüntüyü nasıl oluşturuyor?
Görüntü üretiminde de model bir fotoğraf arşivinden uygun resmi bulup kullanıcıya vermiyor. Üretici modeller eğitim sırasında görsellerle metin açıklamaları arasındaki ilişkileri öğreniyor ve daha sonra tamamen yeni piksel düzenleri oluşturabiliyor.
Diffusion adı verilen yöntem uzun süre görüntü üretiminin en önemli tekniklerinden biri oldu. Bu sistemlerde eğitim sırasında görüntülere kontrollü biçimde gürültü ekleniyor ve model bu gürültünün nasıl geri alınacağını öğreniyor. Üretim sırasında rastgele gürültüden başlanarak görüntü adım adım istenen metin açıklamasına yaklaştırılıyor.
Yeni nesil sistemlerde Transformer tabanlı görüntü modelleri ve farklı üretim mimarileri de kullanılıyor. Temel prensip yine aynı noktaya dayanıyor: model eğitim sırasında öğrendiği görsel dağılımlardan yararlanarak daha önce birebir var olmayan yeni bir çıktı oluşturuyor.
Yapay zeka sesi ve videoyu nasıl üretiyor?
Ses modellerinde konuşma dalgaları bilgisayarın işleyebileceği sayısal temsillere dönüştürülüyor. Sistem konuşmanın fonetik yapısını, ses tonunu, ritmi ve diğer akustik özellikleri öğrenerek metinden konuşma oluşturabiliyor veya konuşmayı metne çevirebiliyor.
Video üretimi çok daha ağır bir hesaplama problemi. Model yalnızca tek bir görüntünün doğru görünmesini değil, art arda gelen yüzlerce karenin de birbirleriyle tutarlı olmasını sağlamak zorunda. Bir insan yürürken yüzün, kıyafetlerin, ışığın ve çevredeki nesnelerin kareler boyunca tutarlı kalması gerekiyor.
Bu nedenle video üretim modellerinin hesaplama ve bellek ihtiyacı görüntü modellerinden çok daha yüksek olabiliyor. Günümüzde yapay zeka hızlandırıcılarına yönelik talebin önemli bölümü de bu tür büyük modellerin eğitimi ve çalıştırılmasından kaynaklanıyor.
Neden yapay zeka için bu kadar güçlü ekran kartları gerekiyor?
Derin öğrenmenin merkezinde çok büyük matris işlemleri bulunuyor. GPU’lar aynı anda çok sayıda küçük matematiksel işlemi paralel biçimde gerçekleştirebildikleri için yapay zeka hesaplamalarına son derece uygun.
Modern yapay zeka hızlandırıcıları klasik grafik işleme görevlerinin yanında düşük hassasiyetli matris işlemleri için özel donanımlar da taşıyor. Eğitim sırasında yüzlerce, binlerce hatta çok daha fazla hızlandırıcı birbirine bağlanarak tek bir büyük model üzerinde çalışabiliyor.
Modelin boyutu büyüdükçe yalnızca hesaplama gücü değil, bellek kapasitesi ve bellek bant genişliği de kritik hale geliyor. Milyarlarca parametrenin saklanması ve işlem sırasında hızla GPU’lara aktarılması gerektiği için veri merkezi yapay zeka sistemlerinde yüksek bant genişlikli HBM bellekler yaygın biçimde kullanılıyor.
Modelin milyarlarca parametresi olması neden önemli?
Parametre sayısı modelin karmaşık ilişkileri temsil etme kapasitesini etkileyen unsurlardan biri. Daha fazla parametre, uygun eğitim koşullarında modele daha fazla örüntü öğrenebilmesi için daha geniş bir matematiksel alan sağlayabiliyor.
Ancak daha büyük model her durumda daha iyi model anlamına gelmiyor. Eğitim verisinin kalitesi, mimari, eğitim yöntemi, veri miktarı ve çıkarım sırasında kullanılan teknikler de sonucu ciddi biçimde etkiliyor. Daha küçük ancak iyi eğitilmiş bir model belirli görevlerde çok daha büyük bir modele yaklaşabiliyor veya onu geçebiliyor.
Bazı modern modeller ayrıca Mixture of Experts olarak adlandırılan yapılardan yararlanıyor. Bu sistemlerde modelin bütün parametreleri her token için aynı anda kullanılmak yerine girişe göre yalnızca belirli uzman bölümleri etkinleştirilebiliyor. Böylece toplam model kapasitesi büyütülürken her işlemde kullanılan hesaplama miktarı kontrol altında tutulabiliyor.
Yapay zeka gerçekten düşünüyor mu?
Bu sorunun cevabı “düşünmek” kelimesine hangi anlamın verildiğine bağlı. Modern yapay zeka sistemleri problem çözebiliyor, plan oluşturabiliyor, metinler arasında ilişki kurabiliyor, kod yazabiliyor ve daha önce doğrudan görmediği bazı problemlere çözüm üretebiliyor.
Ancak bu yetenekler bir insan beyninin çalışma biçiminin kopyalanmasıyla ortaya çıkmıyor. Modelin duyguları, biyolojik ihtiyaçları veya insanlarla aynı türde öznel deneyime sahip olduğunu gösteren bilimsel bir kanıt bulunmuyor. Yapay zekanın dışarıdan son derece insansı görünen dil üretmesi, içeride insan beynindeki süreçlerin aynısının gerçekleştiği anlamına gelmiyor.
“Yapay zeka yalnızca kelime tahmin ediyor” ifadesi de tek başına resmi eksik bırakıyor. Teknik olarak büyük bir dil modelinin temel üretim işlemi sonraki tokenın olasılığını hesaplamak olsa da bunu yapabilmesi için çok karmaşık temsiller ve ilişkiler oluşturması gerekiyor. Bugünkü araştırmaların önemli bölümü de bu iç temsillerin tam olarak nasıl oluştuğunu anlamaya odaklanıyor.
Yapay zeka neden bazen çok basit şeylerde hata yapıyor?
Bir model karmaşık bir program yazabilirken basit bir mantık sorusunda hata yapabiliyor. Bunun nedeni yapay zekanın yeteneklerinin insan zekasındaki gibi düzenli bir hiyerarşi oluşturmaması. Belirli bir konuda güçlü performans göstermesi, daha kolay görünen her görevi otomatik olarak çözebileceği anlamına gelmiyor.
Eğitim verisinin yapısı, sorunun nasıl ifade edildiği ve modelin çıkarım sırasında izlediği yol sonucu değiştirebiliyor. Aynı soru küçük bir ifade değişikliğiyle farklı cevaplara bile yol açabiliyor.
Bu nedenle yapay zeka çıktısını klasik bilgisayar programındaki deterministik fonksiyon sonucu gibi değerlendirmek doğru değil. Özellikle hukuk, sağlık, finans, güvenlik veya kritik mühendislik kararlarında model çıktısının bağımsız biçimde doğrulanması gerekiyor.
Yapay zeka her konuşmadan anında öğreniyor mu?
Bir sohbet modeline yazılan yeni bilgi genellikle modelin temel parametrelerini o anda değiştirmiyor. Kullanıcının mesajı mevcut konuşmanın bağlamına ekleniyor ve model bu bilgiye konuşma boyunca erişebiliyor ancak bu süreç temel modelin yeniden eğitildiği anlamına gelmiyor.
Modelin gerçekten yeni bilgiler öğrenmesi için ayrı bir eğitim, ince ayar veya başka bir kalıcı bilgi mekanizması gerekiyor. Bazı sistemler ayrıca kullanıcı tercihlerini veya önceki konuşmalardan belirli bilgileri ayrı bir hafıza sistemi üzerinden saklayabiliyor; bu sistem modelin temel ağırlıklarından farklı çalışıyor.
Bu ayrım yapay zeka ürünlerini anlamak açısından önemli. Bir sistemin önceki konuşmayı hatırlaması, milyarlarca parametreli temel modelin o konuşmayla yeniden eğitildiğini göstermiyor.
Yapay zekanın bundan sonraki aşaması ne?
Yapay zeka sistemleri yalnızca metin üreten sohbet botlarından giderek daha fazla araç kullanabilen sistemlere dönüşüyor. Güncel modeller web’de araştırma yapabiliyor, kod çalıştırabiliyor, dosyaları analiz edebiliyor, görüntü ve ses işleyebiliyor ve belirli görevleri birden fazla adım halinde yürütebiliyor.
Bu sistemlerde dil modeli tek başına bütün işi yapmak yerine bir tür karar ve koordinasyon katmanı haline gelebiliyor. Matematiksel işlem gerektiğinde hesaplama aracı, güncel bilgi gerektiğinde web erişimi, bir dosya üzerinde çalışılması gerektiğinde ilgili uygulama devreye girebiliyor.
Buna rağmen temel çalışma mantığı büyük ölçüde aynı çizgide kalıyor. Çok büyük veri kümelerinden ilişkiler öğreniliyor, bu bilgiler milyarlarca sayısal parametre içinde temsil ediliyor ve yeni bir giriş geldiğinde model öğrendiği dağılımlar üzerinden en uygun çıktıyı oluşturmaya çalışıyor. Kullanıcı tarafında birkaç saniyelik bir cevap olarak görünen işlem, arka planda çok büyük miktarda matris hesabı, bellek erişimi ve olasılık hesabından oluşuyor.
